NVIDIA CMX
公开 / 厂商口径报道 2026 下半年最高约 5×相对「传统存储」· 基线未公开
TECHNICAL BRIEF · 对照 NVIDIA CMX
溢出显存的 KV Cache 不重算,落到 G2.5 上下文存储层。CMX 与 FX 补的都是这一层。
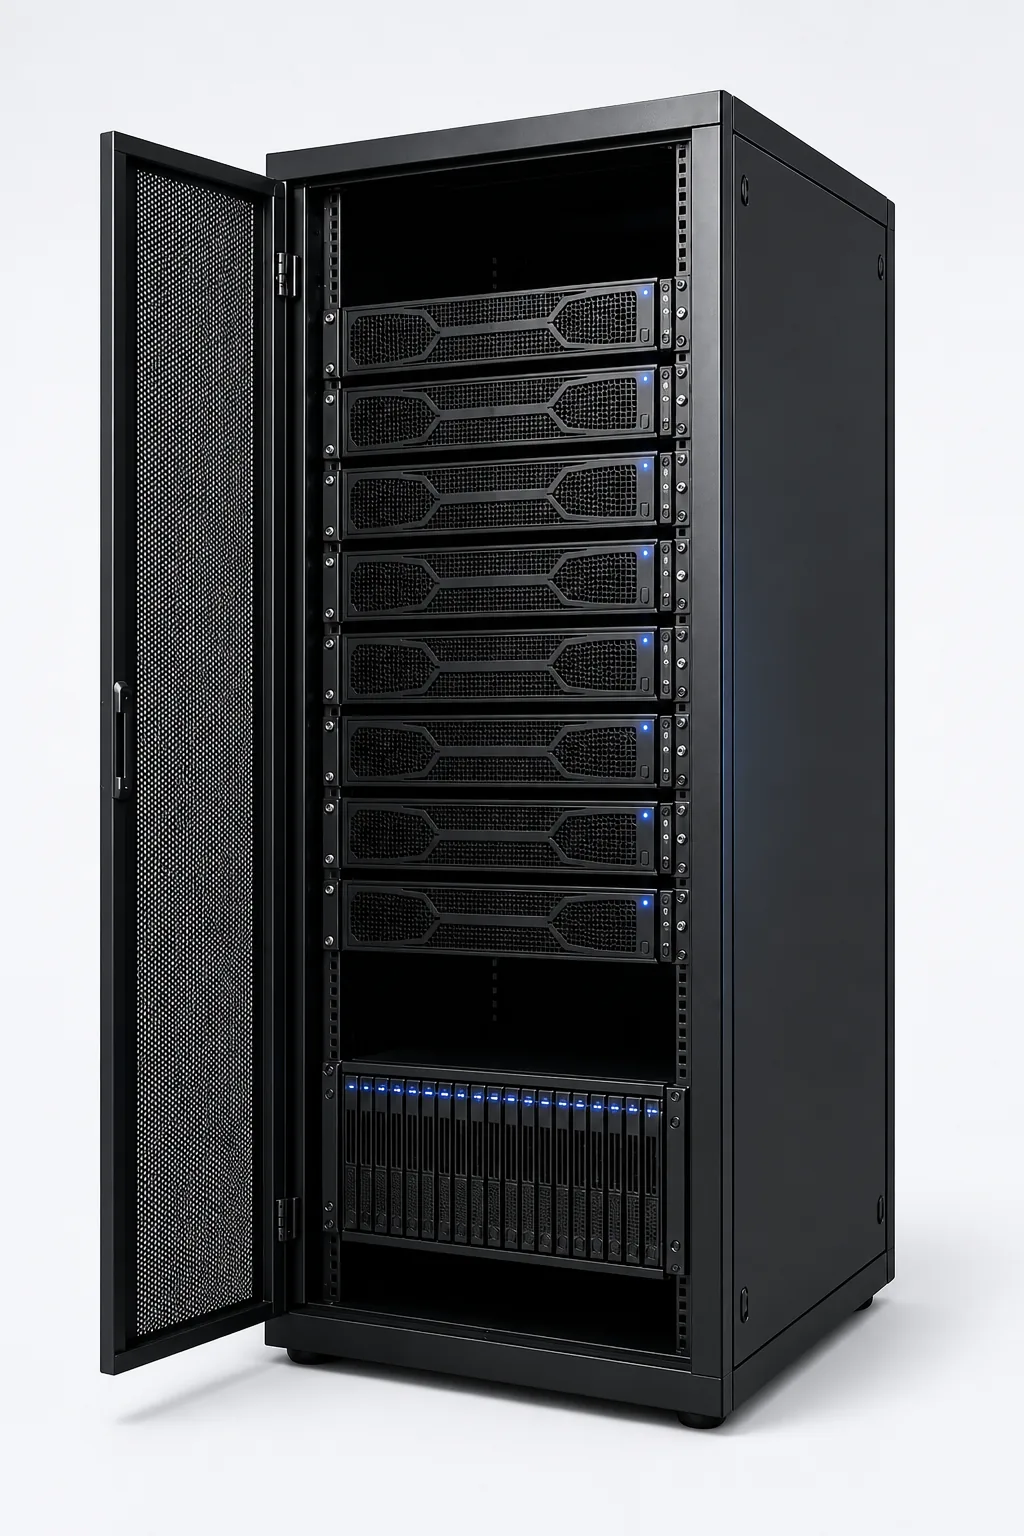 GPU 算力节点芯元一 FX 存储服务器
480B 长上下文冷恢复 · TTFT p50 · 并发 16
对无外存重算 8.6–20× · R2 签字实测
10–30%有效计算即使部署一百万张 GPU,真正用于计算的时间大概也只有 10% 到 30%。
金正浩(Joungho Kim)· KAIST · 行业称「HBM 之父」 · 《东亚日报》专访 · 2026-07 转述
公开趋势:算力 vs 存储
带宽:HBM/DRAM 为厂商峰值;G2.5 为 R1 实测;本地盘为 PCIe Gen4 单盘级;NFS 由 R9 加载时推算。GPU 利用率 46.7%→62.8% 为 R1(20 次/小时切换)。
KV Cache 下沉,不重算 RDMA直连存储 命中即预取回显存
NVIDIA 数字为厂商公开口径,基线未披露。芯元一数字全部附报告编号(R1–R9),接受复验。不构成贬损或替代承诺。金正浩原话为行业公开判断,不是芯元一实测;利用率 46.7%→62.8% 才是 R1。 NVIDIA CMX 产品页 · NVIDIA Technical Blog · T客邦转述《东亚日报》金正浩专访 · Epoch AI · Trends in ML hardware(2023)
验收报告全文免费下载。下面两张表是厂商公开规格,用来对照卡型,不是我方实测吞吐。
多模型 Token 供给能力与性能验收测试报告(对外正式版 V2.3)全文免费。与证据库 R1–R9 的付费 PDF 不是同一套文件。
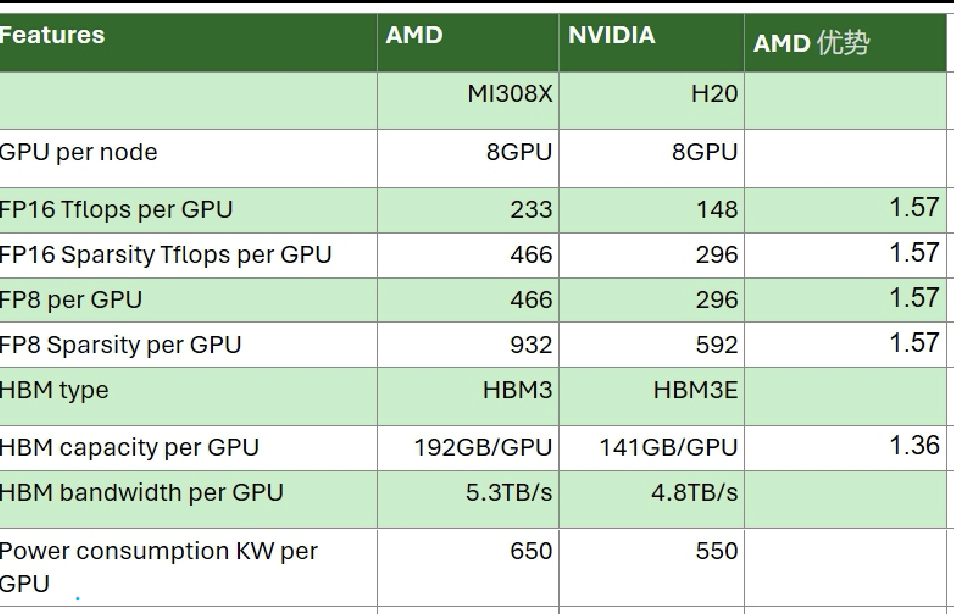
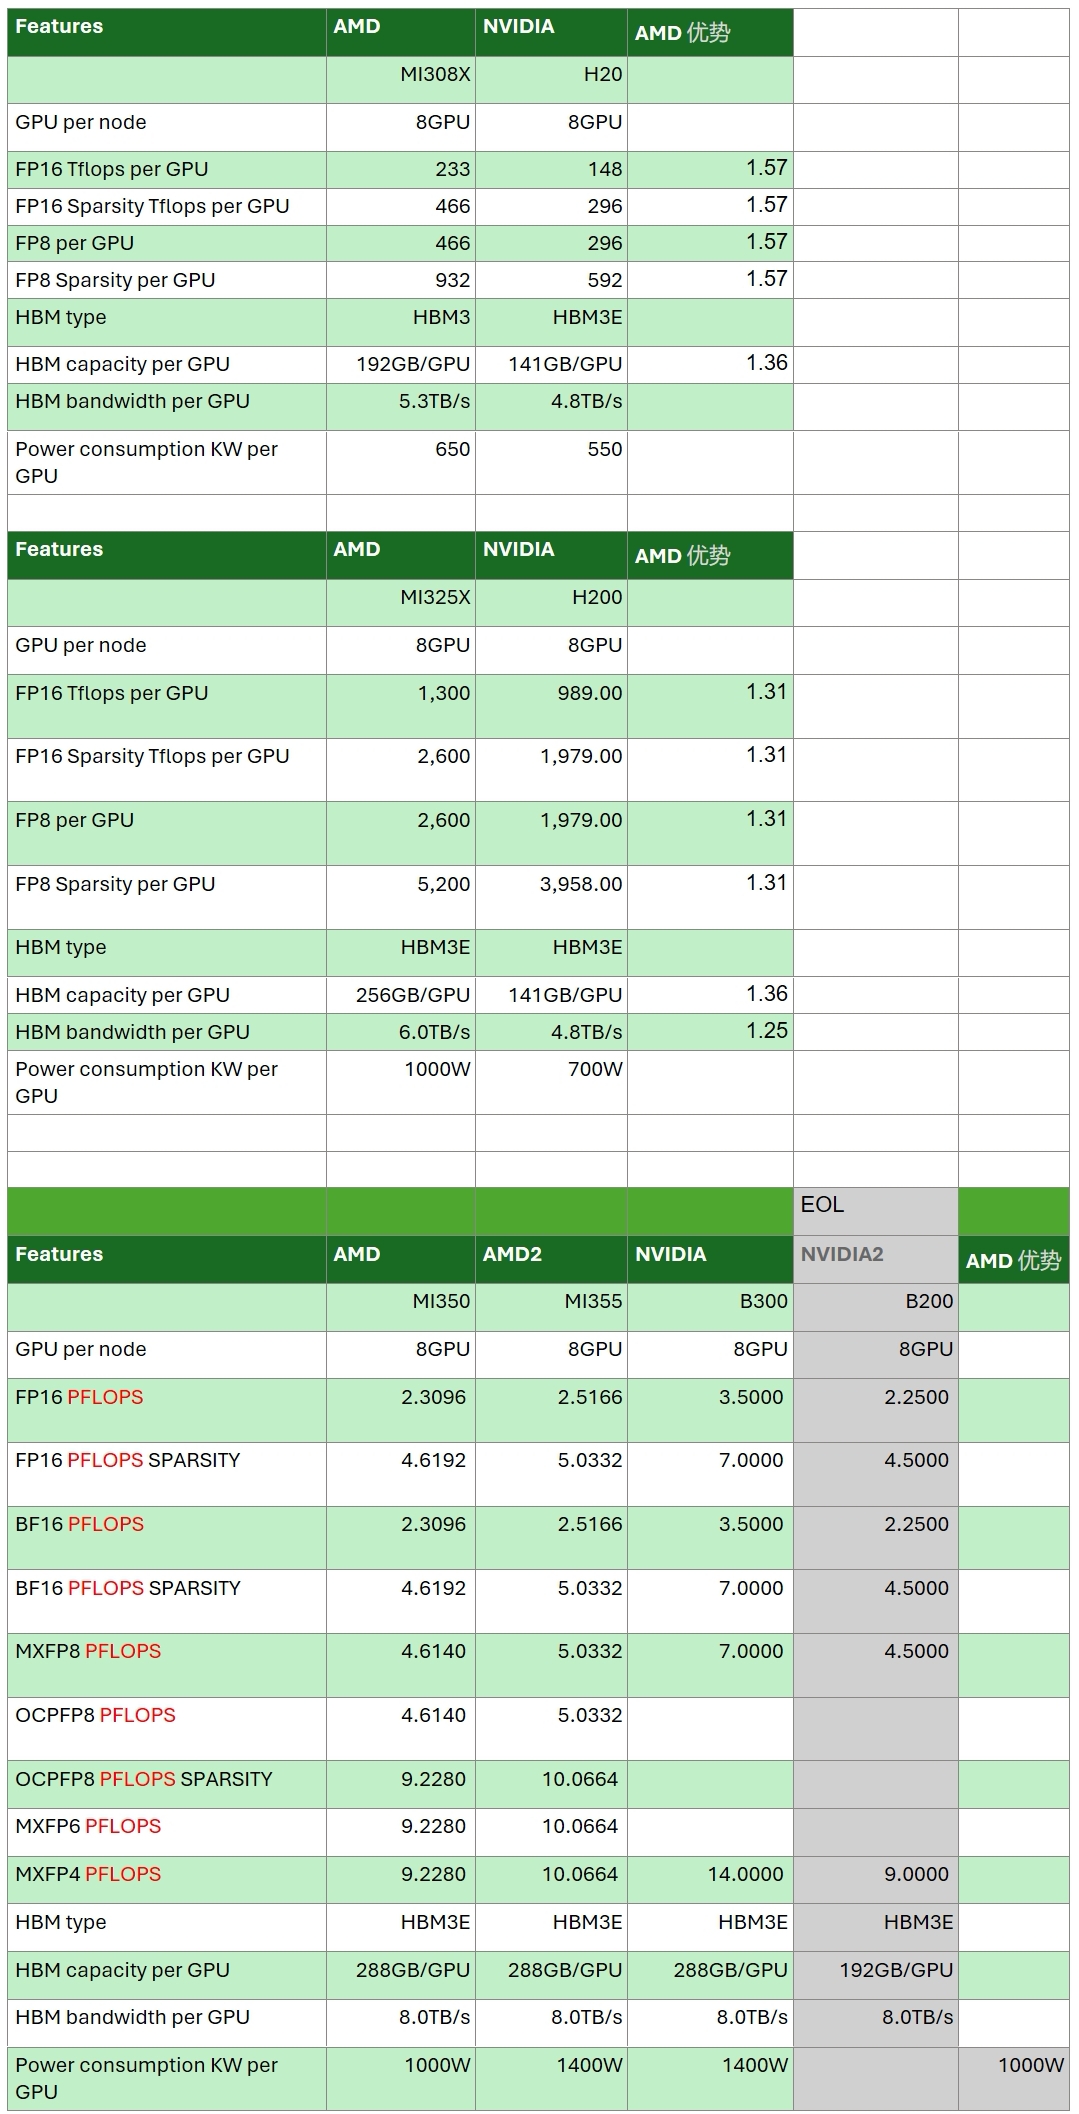
厂商公开规格对照,不是我方实测吞吐,也不是相对英伟达的成交倍数。